Spark技術(shù)在大數(shù)據(jù)生態(tài)中的核心應(yīng)用與價(jià)值解析
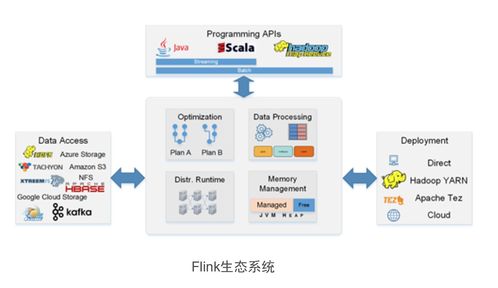
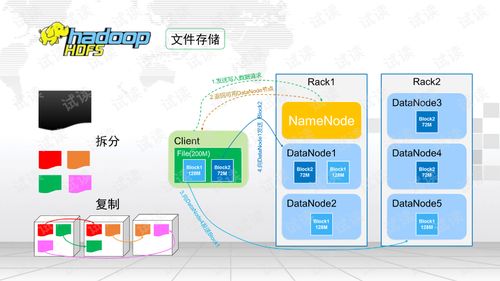
在當(dāng)今大數(shù)據(jù)時(shí)代,數(shù)據(jù)的存儲(chǔ)與處理能力已成為企業(yè)數(shù)字化轉(zhuǎn)型的關(guān)鍵杠桿。Apache Spark,作為一款通用、快速且易于使用的分布式計(jì)算引擎,在大數(shù)據(jù)生態(tài)系統(tǒng)中扮演著不可替代的核心角色。本文將簡要介紹大數(shù)據(jù)生態(tài)的基本構(gòu)成,梳理Spark的技術(shù)特點(diǎn)與應(yīng)用場景,并分析其在數(shù)據(jù)處理中的實(shí)際作用。\n\n## 一、大數(shù)據(jù)生態(tài)簡介\n\n大數(shù)據(jù)生態(tài)是一個(gè)涵蓋數(shù)據(jù)采集、存儲(chǔ)、處理、查詢、分析與可視化的復(fù)雜技術(shù)棧。典型組件包括:\n\n- 數(shù)據(jù)存儲(chǔ)層:如HDFS(分布文件系統(tǒng))、Amazon S3(云存儲(chǔ))提供持久化的海量數(shù)據(jù)存儲(chǔ)能力;\n- 資源管理與協(xié)調(diào)層:YARN或K8s負(fù)責(zé)任務(wù)調(diào)度、資源分配,而組件如ZooKeeper確保服務(wù)一致性和協(xié)調(diào)性;\n- 計(jì)算框架:早期用MapReduce(批處理)、Storm(流處理),但目前業(yè)界主流正在由Spark替換多數(shù)構(gòu)建模式呈現(xiàn);\n- 數(shù)據(jù)查詢與抽象層:Hive以SQL類Lang處理靜態(tài)數(shù)據(jù)更適基礎(chǔ)規(guī)劃Or套插件;Presto也被更多承載Ad-Hoc查詢與大容量獲取需要之間產(chǎn)生深度共匯。同時(shí)如圖算法分析庫, FLink將態(tài)實(shí)踐持久打通一致實(shí)迭代。而這個(gè)繁榮衍生前提下主流針對(duì)多式異構(gòu)跨量系統(tǒng)模塊應(yīng)用思路實(shí)支的核心整合穩(wěn)定還是歸依被Spark統(tǒng)領(lǐng)\n\n許多企業(yè)在提到大規(guī)模分析系統(tǒng)采用時(shí)所常見操作即視《一棧生成
如若轉(zhuǎn)載,請(qǐng)注明出處:http://m.txfm.com.cn/product/30.html
更新時(shí)間:2026-09-30 05:25:54